Die Trefferliste bleibt bestehen. Der Kampf verlagert sich auf den Antwortblock darüber.
GEO steht für Generative Engine Optimization. Gemeint ist die Arbeit daran, dass ein Unternehmen in den Antworten generativer Systeme auftaucht, also in ChatGPT, Perplexity, Google AI Overviews oder Claude. Der Unterschied zur klassischen Suchmaschinenoptimierung ist kleiner, als viele Anbieter behaupten, und größer, als die meisten Redaktionen bisher eingeplant haben.
Generative Engine Optimization (GEO) bezeichnet die systematische Arbeit daran, dass ein Unternehmen in den Antworten generativer KI-Systeme wie ChatGPT, Perplexity oder Google AI Overviews genannt und als Quelle zitiert wird. Optimiert wird nicht die Position in einer Trefferliste, sondern die Wahrscheinlichkeit, dass ein Modell die eigene Marke in seine Antwort aufnimmt.
Der Rest dieses Textes zerlegt diesen Satz in seine Bestandteile: was ein Modell überhaupt liest, wann es zitiert und an welchen Stellen Sie eingreifen können.
Generative Engine Optimization heißt: in der Antwort vorkommen, nicht auf der Ergebnisliste
Die Abkürzung stammt aus einer Forschungsarbeit mit dem Titel "GEO: Generative Engine Optimization", eingereicht im November 2023 von Pranjal Aggarwal und Kolleginnen und Kollegen (Quelle: https://arxiv.org/abs/2311.09735). Dort wird untersucht, wie sich die Sichtbarkeit einer Quelle in generierten Antworten durch Eingriffe am Text verändern lässt, etwa durch belegte Aussagen, benannte Quellen oder eine klarere Sprache. Parallel kursieren die Bezeichnungen AEO für Answer Engine Optimization und LLMO für Large Language Model Optimization. Gemeint ist jeweils dasselbe Problem.
Die Begriffsvielfalt hat einen praktischen Grund. Die Systeme, um die es geht, sind keine Suchmaschinen im alten Sinn und auch keine reinen Sprachmodelle, sondern Mischformen aus Modell und Suchindex. Google AI Overviews sitzt auf der klassischen Suche auf. Perplexity ist von Anfang an als Antwortmaschine gebaut. ChatGPT beantwortet je nach Einstellung dieselbe Frage einmal aus dem Training und einmal aus dem Netz. Was für das eine System gilt, gilt für das nächste nur zur Hälfte.
Der Unterschied zur Trefferliste ist handfest. Eine klassische Suchergebnisseite gibt Ihnen zehn blaue Links und überlässt Ihnen die Auswahl. Wer auf Position vier steht, bekommt weniger Klicks als Position eins, aber er existiert. Er ist sichtbar, anklickbar, vergleichbar.
Eine generative Antwort funktioniert anders und liefert einen fertigen Fließtext, oft mit drei bis fünf Namen darin und einer Handvoll Fußnoten am Rand. Wer in diesem Text nicht vorkommt, existiert für die fragende Person schlicht nicht. Es gibt keine Position elf, auf die man sich hocharbeitet. Es gibt vorkommen oder nicht vorkommen.
Hinzu kommt, dass viele dieser Antworten den Klick ersetzen. Wer nach einer Definition fragt, bekommt sie im Antwortfeld und ruft die Quellseite nie auf. Für die Betreiber dieser Quellseite verschiebt sich damit der Wert der Arbeit: Der Text wirkt weiter, aber er wirkt an einer Stelle, die keine Sitzung im eigenen Analysewerkzeug erzeugt. Genau deshalb taugt Traffic allein nicht mehr als Maß für Sichtbarkeit.
Daraus folgt eine unangenehme Konsequenz für die Planung. Sichtbarkeit war lange eine kontinuierliche Größe, ein Rang zwischen 1 und 100. In generativen Antworten ist sie binär, und zwar pro Frage, pro Modell und pro Abfragezeitpunkt. Dasselbe Unternehmen kann bei ChatGPT genannt werden und bei Perplexity fehlen, und beim nächsten Durchlauf kippt das Ergebnis.
Ein zweiter Punkt wird oft übersehen. Modelle nennen nicht nur Unternehmen, sie ordnen sie ein. Eine Antwort auf "Welche Agentur eignet sich für den Mittelstand?" enthält nicht bloß Namen, sondern Zuschreibungen: für wen geeignet, in welchem Preisrahmen, mit welcher Spezialisierung. GEO umfasst deshalb beides. Erstens die Frage, ob Sie überhaupt vorkommen. Zweitens die Frage, mit welcher Beschreibung Sie vorkommen.
Der dritte Fall ist der stille. Ein Modell kann Sie nennen und dabei etwas Falsches behaupten, eine eingestellte Leistung, einen alten Standort, eine Zuordnung zur falschen Branche. Solche Fehler entstehen nicht aus Böswilligkeit, sondern aus veralteten oder widersprüchlichen Fundstellen. Auffallen wird das niemandem, solange niemand nachfragt. Zur Bestandsaufnahme gehört deshalb, die Antworten regelmäßig selbst zu lesen statt sie zu vermuten.
Wie eine KI-Antwort entsteht, bevor Sie sie lesen
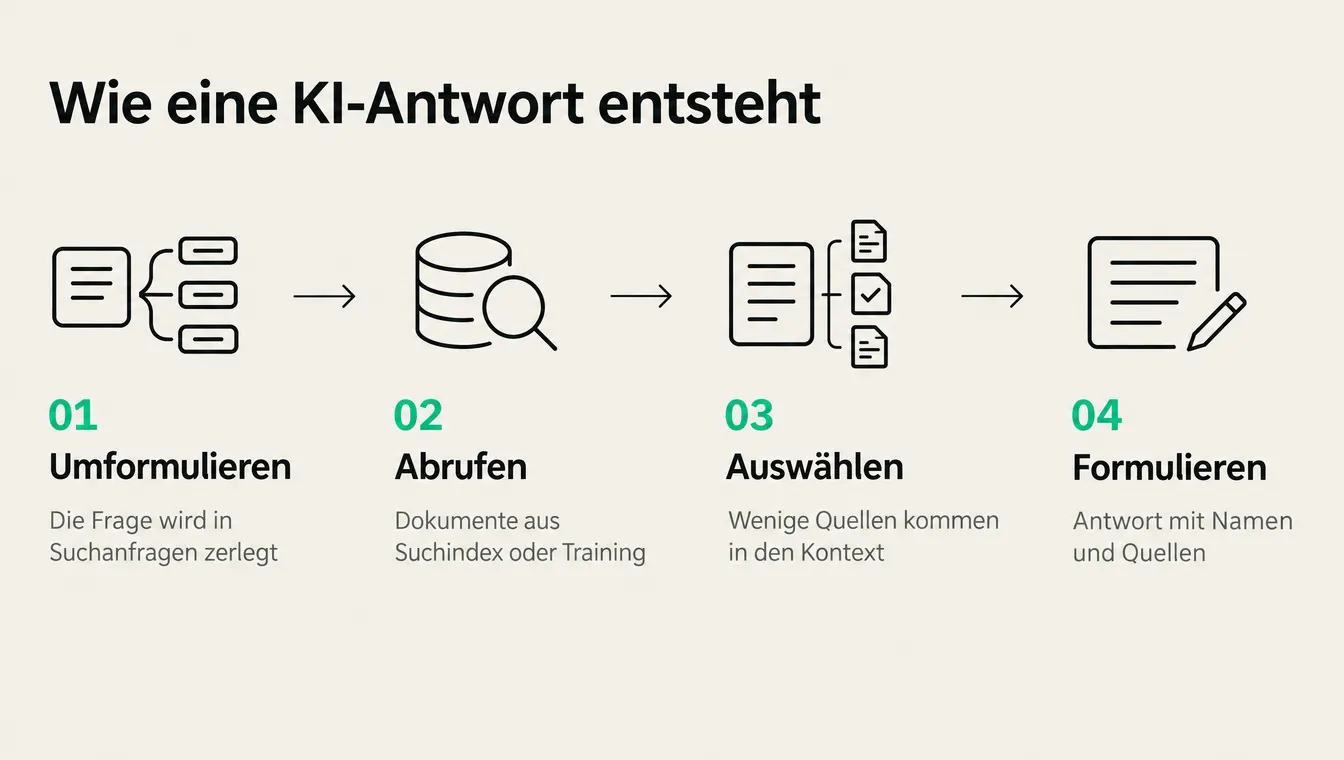
Wer verstehen will, wo Einfluss möglich ist, muss den Ablauf kennen. Vier Schritte lassen sich von außen beobachten, ohne dass man Interna der Anbieter kennen müsste.
Schritt eins, die Umformulierung. Ihre Frage wird selten so gesucht, wie Sie sie eingeben. Aus "wer kann mir bei KI-Sichtbarkeit helfen" macht das System mehrere Suchanfragen, etwa "GEO Agentur Deutschland" oder "AI Visibility Dienstleister". Diese Zwischenschritte sind bei Perplexity und im Google AI Mode teilweise sichtbar, und genau dort entscheidet sich, welcher Suchraum überhaupt aufgemacht wird.
Schritt zwei, das Abrufen. Für diese Suchanfragen holt sich das System Dokumente. Bei Perplexity und ChatGPT mit aktivierter Suche läuft das über einen angeschlossenen Suchindex, bei Google AI Overviews über den eigenen Index. Ohne Suchanbindung greift ein Modell nur auf das zurück, was im Training verankert war, und der Trainingsstand liegt Monate zurück. Beide Wege sind für Sie relevant, weil Sie auf beiden vorkommen oder fehlen können.
Schritt drei, die Auswahl. Aus vielleicht dreißig abgerufenen Dokumenten landen wenige im Kontextfenster. Ausgewählt wird, was zur umformulierten Frage passt, was aus einer Quelle stammt, die das System als brauchbar behandelt, und was die Frage möglichst direkt beantwortet. Ein Text, der die Antwort erst im vierten Absatz gibt, verliert gegen einen Text, der sie im ersten gibt.
Schritt vier, die Formulierung mit Zitat. Aus den ausgewählten Dokumenten schreibt das Modell einen zusammenhängenden Text und hängt Belege an. Zitiert wird dabei nicht zwingend die beste Quelle, sondern die Passage, aus der eine Aussage am saubersten übernommen werden konnte. Listen, klare Definitionen und Tabellen werden auffällig häufig zur Zitatquelle, weil sie sich ohne Interpretation übernehmen lassen. Ein Satz, der die Frage vollständig beantwortet und für sich allein stehen kann, hat es in diesem Schritt leichter als ein Absatz, der erst durch den Kontext davor verständlich wird.
Zwei Uhren laufen dabei nebeneinander, und das erklärt einen Großteil der Verwirrung im Markt. Was ein Modell aus dem Training weiß, ist ein Standbild aus der Vergangenheit und ändert sich erst mit der nächsten Modellversion. Was es über die Suche nachlädt, ist tagesaktuell. Eine neue Seite kann also binnen Tagen in Perplexity auftauchen und trotzdem monatelang unbekannt bleiben, sobald jemand dasselbe Modell ohne Suchanbindung fragt. Wer Wirkung messen will, muss die beiden Fälle auseinanderhalten.
An welchen Stellen können Sie eingreifen? Auf Schritt eins haben Sie keinen direkten Zugriff, aber Sie können Ihre Inhalte auf die tatsächlich gestellten Fragen ausrichten statt auf Keywords. Auf Schritt zwei wirken Sie über technische Erreichbarkeit, über die Freigabe der Crawler generativer Anbieter in der robots.txt und über die Frage, ob Ihre Aussagen auch auf fremden Seiten stehen. Auf Schritt drei wirken Sie über den Aufbau: eine Definition am Anfang, benannte Zahlen mit Quelle, Überschriften im Wortlaut der Frage. Auf Schritt vier wirken Sie über Zitierbarkeit, also über Absätze, die aus dem Text herausgeschnitten und ohne Kontext verwendet werden können. Der Test dafür ist einfach: Nehmen Sie einen beliebigen Absatz Ihrer Seite, lesen Sie ihn ohne die Überschrift darüber, und prüfen Sie, ob er allein noch eine vollständige Aussage trägt.
Was Sie nicht beeinflussen können, gehört zur ehrlichen Bilanz dazu. Gewichtungen innerhalb der Modelle sind nicht öffentlich, Anbieter ändern ihre Auswahlverfahren ohne Ankündigung, und identische Prompts liefern an zwei Tagen unterschiedliche Antworten. Wer Ihnen eine feste Platzierung in KI-Antworten zusagt, verkauft etwas, das technisch niemand liefern kann. Realistisch ist ein anderes Versprechen: die Wahrscheinlichkeit erhöhen, dass Ihr Name in die Auswahl gerät, und den Zustand über wiederholte Messungen belegen statt über Gefühl.
Links entscheiden Sie zwischen zehn Optionen. Rechts hat das Modell bereits entschieden.
Wo GEO und SEO auseinanderlaufen
Die Unterschiede lassen sich sauber gegenüberstellen, sobald man die richtigen Fragen stellt. Wenn Ihnen die klassische Seite fehlt: Was ist SEO erklärt die Grundlagen, und GEO vs. SEO: Was sich ändert ordnet die Verschiebung zeitlich ein.
| Frage | Klassisches SEO | GEO |
|---|---|---|
| Ziel | Platzierung in der Trefferliste, Klick auf die eigene Seite | Nennung im Antworttext, Zitat als Quelle |
| Erfolgsmaß | Position, Impressionen, organische Klicks | Nennungsrate und Zitationsrate über mehrere Modelle |
| Einheit der Optimierung | Die einzelne URL zu einem Keyword | Die Entität, also das Unternehmen als erkennbarer Begriff |
| Rolle von Backlinks | Direkter Rankingfaktor | Indirekt: Erwähnungen auf fremden Seiten machen die Entität abrufbar |
| Rolle von Struktur | Hilfreich für Crawling und Snippets | Voraussetzung für die Übernahme einzelner Passagen |
| Messbarkeit | Search Console, Rank-Tracker, weitgehend stabil | Eigene Prompt-Läufe je Modell, Ergebnisse schwanken |
| Zeithorizont | Wochen bis Monate bis zur Wirkung | Trainingsstand plus Abrufindex, dadurch zwei getrennte Uhren |
| Wettbewerb | Die anderen Ergebnisse auf derselben Seite | Die wenigen Namen, die es überhaupt in den Antworttext schaffen |
Gleich bleibt mehr, als der Markt gerade behauptet. Ein Modell mit Suchanbindung greift auf denselben Index zu, den auch die klassische Suche nutzt. Wer technisch nicht erreichbar ist, wer seine Seiten vor Crawlern sperrt oder Inhalte erst nach dem Laden per JavaScript ausliefert, fällt in beiden Welten aus. Auch die inhaltliche Substanz zählt zweimal: ein Text ohne eigene Aussage rankt schlecht und wird ebenso wenig zitiert. GEO ersetzt SEO also nicht, sondern setzt es voraus. Wer die Grundlagen nicht hat, gewinnt nichts dadurch, dass er eine neue Disziplin obendrauf setzt.
Nicht gleich bleibt die Einheit, um die es geht. SEO optimiert Seiten, GEO optimiert eine Entität. Ein Modell hält kein Ranking für eine einzelne URL vor, sondern eine Vorstellung davon, was Ihr Unternehmen ist, wofür der Name steht und in welchem Zusammenhang er üblicherweise genannt wird. Diese Vorstellung entsteht aus vielen Fundstellen, von denen die wenigsten Ihnen gehören. Damit verschiebt sich auch die Arbeit: weniger Feinschliff an der eigenen Landingpage, mehr Aufbau überprüfbarer Spuren an anderer Stelle. Verschoben hat sich ebenso das Erfolgsmaß. Eine Position lässt sich täglich abgreifen und in eine Zeitreihe legen. Eine Nennung dagegen müssen Sie erzeugen, indem Sie dieselben Prompts in festen Abständen über mehrere Modelle laufen lassen und auszählen, wie oft Ihr Name fällt und wie oft Ihre Domain als Beleg erscheint. Das ist aufwendiger, es ist unschärfer, und es ist derzeit die einzige belastbare Auskunft darüber, ob die Arbeit wirkt.
Was passiert, wenn ein Modell Sie nicht kennt
Eine technisch saubere, inhaltlich brauchbare und für die klassische Suche sichtbare Website reicht für generative Antworten oft trotzdem nicht aus. Ein Modell, das eine Empfehlungsfrage beantwortet, sucht nicht nach der besten Selbstdarstellung, sondern nach einer Quelle, die mehrere Anbieter nebeneinander nennt und einordnet. Solche Quellen sind fast immer Rankinglisten, Vergleichsartikel, Verzeichnisse und Fachbeiträge Dritter. Wer dort fehlt, fehlt in der Antwort, unabhängig von der Qualität der eigenen Seite. Die eigene Domain ist in dieser Logik Beleg, nicht Auslöser: Ihre Seite bestätigt, was ein Modell anderswo aufgeschnappt hat, und liefert die Formulierungen für das Zitat.
Wer in KI-Antworten vorkommen will, muss in fremden Listen stehen. Das ist der Kern. Praktisch heißt es: Präsenz in einschlägigen Branchenverzeichnissen, Beiträge in Fachmedien, überprüfbare Erwähnungen mit Namen und Ort, konsistente Angaben über alle Fundstellen hinweg. Dazu kommt die eigene Seite, die einem Modell die Übernahme leicht machen muss, mit Definitionen im ersten Absatz und Zahlen, die eine benannte Quelle tragen. Der Weg dahin führt über Inhalte, die jemand anderes freiwillig zitiert, nicht über Werbetexte über sich selbst. Das ist kein Sonderfall, sondern der Normalzustand für jedes Unternehmen, das seine Sichtbarkeit bisher ausschließlich auf der eigenen Domain aufgebaut hat.
Wo KI-Antworten heute entstehen
Eine KI-Antwort entsteht nicht an einem Ort. Sechs Systeme prägen den deutschsprachigen Markt, und jedes beschafft sich seine Quellen anders. Wer verstehen will, warum eine Marke in einem System auftaucht und im nächsten nicht, muss diese Unterschiede kennen.
Es gibt drei Wege, wie ein Text überhaupt in eine generierte Antwort gerät: über einen Index, den der Anbieter selbst pflegt; über einen Abruf in dem Moment, in dem jemand fragt; über die Trainingsdaten des Modells. Die ersten beiden Wege lassen sich beeinflussen. Der dritte ist träge und für laufende Arbeit kaum brauchbar.
ChatGPT: eigener Such-Crawler, Quellenliste unter der Antwort
OpenAI trennt seine Crawler nach Zweck. OAI-SearchBot bedient ausschließlich die Suchfunktion; wer ihn per robots.txt aussperrt, erscheint in den Suchergebnissen von ChatGPT nicht mehr. GPTBot sammelt für das Modelltraining, ChatGPT-User ruft eine Seite ab, weil eine Nutzerfrage es verlangt. Diese Einstellungen wirken unabhängig voneinander, laut OpenAI-Dokumentation unter https://developers.openai.com/api/docs/bots.
Praktisch heißt das: Sie können Training verbieten und trotzdem in der Suche sichtbar bleiben. Viele Websites tun versehentlich das Gegenteil.
ChatGPT zeigt Quellen als anklickbare Verweise neben oder unter der Antwort. Sie sind vorhanden, aber schwach platziert. Die Reichweite ist der Grund, warum das trotzdem zählt: OpenAI nannte im Februar 2026 900 Millionen wöchentlich aktive Nutzer, laut Bericht von TechCrunch (https://techcrunch.com/2026/02/27/chatgpt-reaches-900m-weekly-active-users).
Google AI Overviews und AI Mode: zwei Oberflächen, ein Index
AI Overviews sitzen über der klassischen Trefferliste. AI Mode ist ein eigener Modus, in dem die Antwort die Liste ersetzt und Rückfragen möglich sind. Beide greifen auf den Google-Index zu, zerlegen die Frage aber in mehrere Unterabfragen und sammeln Belege für jede davon.
Google berichtete zur I/O 2026, AI Mode habe ein Jahr nach dem Start mehr als eine Milliarde monatliche Nutzer erreicht (Quelle: https://blog.google/products-and-platforms/products/search/search-io-2026/).
Für die Sichtbarkeit ist eine Auswertung von Ahrefs aufschlussreich. Die Studie zeigt: Nur 38 % der in AI Overviews zitierten Seiten standen auch in den Top 10 der organischen Ergebnisse, gemessen an 863.000 Keyword-SERPs, Stand 02.03.2026 (https://ahrefs.com/blog/ai-overview-citations-top-10). Ein Jahr zuvor lag dieser Anteil deutlich höher. Die Rangliste entscheidet also immer weniger darüber, wer zitiert wird.
Perplexity: nummerierte Belege in jeder Antwort
Perplexity betreibt PerplexityBot, um Websites in den eigenen Ergebnissen zu erfassen und zu verlinken, sowie Perplexity-User für Abrufe, die eine konkrete Nutzerfrage auslöst. Beide dienen nach Angaben der Dokumentation nicht dem Training von Modellen (https://docs.perplexity.ai/docs/resources/perplexity-crawlers).
Kein anderes System zeigt Quellen so offensiv. Jeder Satz trägt eine Nummer, jede Nummer führt auf eine Domain. Wer hier zitiert wird, bekommt sichtbare Autorität und gelegentlich einen Klick.
Microsoft Copilot: Bing-Index, und eine Kennzahl für Ihren Zitatanteil
Copilot stützt sich auf den Bing-Index. Interessanter als das Produkt ist, was Microsoft den Betreibern von Websites dazu offenlegt: Die Bing Webmaster Tools weisen inzwischen Intents, Themencluster und einen sogenannten Citation Share aus, also den Anteil der Zitate einer Domain an allen Zitaten zur selben Grounding-Anfrage (Quelle: https://blogs.bing.com/search/June-2026/New-AI-Visibility-Insights-in-Bing-Webmaster-Tools-Intents-Topics-Citation-Share-Compare).
Das ist die erste Stelle, an der ein Plattformbetreiber Zitierhäufigkeit als eigene Metrik behandelt. Wer messen will, ob GEO wirkt, findet dort belastbare Rohdaten statt Schätzungen. Der Perspektivwechsel ist bemerkenswert: Nicht mehr die Position in einer Liste wird berichtet, sondern der Anteil an den Belegen, mit denen eine Maschine ihre Antwort stützt. Wer eine deutschsprachige Domain betreibt, sollte die Zahlen trotzdem vorsichtig lesen, weil der Marktanteil von Bing hierzulande klein ist und die Stichprobe entsprechend dünn ausfallen kann.
Gemini: Quellen erscheinen, aber nicht immer
Die Gemini-App blendet einen Sources-Button unter der Antwort ein oder markiert Stellen im Text. Google schreibt dazu selbst, dass nicht jede Antwort Quellen enthält; fehlt der Button, hat das System für diese Antwort keine Verweise ausgegeben (https://support.google.com/gemini/answer/14143489).
Für Ihre Marke bedeutet das eine unangenehme Asymmetrie. Ihr Inhalt kann die Antwort geprägt haben, ohne dass Ihr Name irgendwo steht.
Claude: Zitate sind Pflichtbestandteil der Antwort
Anthropic hat die Websuche als Werkzeug gebaut. Jedes Suchergebnis kommt mit Titel, URL und einem kurzen zitierten Textausschnitt zurück, und die Zitate lassen sich nicht abschalten; wer Ausgaben an Endnutzer weitergibt, muss die Originalquellen mit anzeigen (Quelle: https://platform.claude.com/docs/en/agents-and-tools/tool-use/web-search-tool).
Welcher Suchdienst dahinterliegt, sagt die Dokumentation nicht. Für die Praxis reicht die Erkenntnis, dass hier ein Retrieval-Partner zwischen Ihrer Seite und der Antwort sitzt, dessen Index Sie nicht direkt kennen.
Was die Modelle zitieren, wenn sie eine Agentur empfehlen
Bei Empfehlungsfragen zitieren KI-Systeme auffällig häufig Vergleichsartikel Dritter statt der Seiten der Anbieter selbst. Dieses Muster ist kein Zufall und kein Fehler der Modelle. Es folgt aus der Form der Frage.
"Welche GEO-Agentur passt zu meinem Unternehmen" ist eine Vergleichsfrage. Ein Listicle beantwortet sie in der Form, in der sie gestellt wurde: mehrere Anbieter, benannt, mit Merkmalen versehen, gegeneinander gestellt. Eine Anbieterseite beantwortet eine andere Frage, nämlich warum genau dieser Anbieter gut ist. Das Modell braucht für die erste Frage einen Text, der schon vergleicht.
Dazu kommt ein Risikomotiv. Ein Sprachmodell, das eine Empfehlung ausspricht, stützt sich lieber auf eine Quelle, die mehrere Namen nennt, als auf eine, die nur sich selbst nennt. Selbstauskunft ist schwach belegt, Fremdauskunft trägt weiter. Taucht derselbe Name in einem Fachportal, einem Verzeichnis und einem Vergleichstext auf, entsteht Übereinstimmung über Domains hinweg. Genau diese Übereinstimmung ist der Ersatz für die Prüfung, die ein Modell nicht durchführen kann.
Der dritte Punkt ist der handwerklichste.
Es zählt die Extrahierbarkeit. Vergleichsseiten liefern Entität und Eigenschaft in einer Zeile: Name, Sitz, Schwerpunkt, Preisrahmen. Verzeichnisse liefern dasselbe in Feldern. Eine Agenturseite verpackt dieselbe Information in Fließtext, Bildunterschriften und Claims. Pro Textmenge steckt darin weniger verwertbare Aussage, und weniger verwertbare Aussage bedeutet weniger Anlass zu zitieren.
Die Ahrefs-Zahl von oben passt in dieses Bild. Wenn nur ein gutes Drittel der Zitate aus den Top 10 stammt, dann sucht das System nicht die beste Position, sondern den passendsten Absatz. Fachportale und Vergleichsartikel gewinnen dabei, weil sie thematisch schmal und antwortförmig geschrieben sind.
Daraus folgt eine unbequeme Konsequenz für die eigene Website. Ihre Seite kann eine Vergleichsfrage kaum gewinnen, egal wie gut sie ist. Sie kann aber die Quelle sein, aus der sich Dritte bedienen, wenn sie über Ihren Markt schreiben. Der Hebel liegt also doppelt: eigene Seite als saubere Beschreibung der Entität, plus Präsenz in dem Korpus, der den Markt beschreibt.
Zero-Click: was passiert, wenn niemand mehr klickt
Die Mechanik ist einfach. Früher war die Suchseite ein Wegweiser, heute ist sie ein Ziel. Wer eine vollständige Antwort bekommt, hat keinen Grund mehr, eine Website zu öffnen.
Die Größenordnung lässt sich beziffern. Eine Auswertung von SparkToro auf Basis von Similarweb-Clickstream-Daten kommt für Januar bis April 2026 auf 68,01 % der Google-Suchen in den USA ohne jeden Klick, gegenüber 60,45 % im Jahr 2024 (Quelle: https://sparktoro.com/blog/in-2026-less-than-one-third-of-google-searches-still-send-a-click/, eingeordnet auch bei https://searchengineland.com/google-zero-click-searches-2026-study-479717).
Feiner aufgelöst hat das Pew Research Center dieselbe Frage. Die Studie zeigt: Bei Suchen mit KI-Zusammenfassung klickten Nutzer in 8 % der Besuche auf ein klassisches Ergebnis, ohne Zusammenfassung waren es laut Pew 15 %; auf einen Link innerhalb der Zusammenfassung entfiel 1 % der Besuche. Grundlage waren 68.879 Suchanfragen von 900 Erwachsenen im März 2025, laut https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/.
Wirtschaftlich trifft das zuerst alle Geschäftsmodelle, die Traffic direkt verkaufen. Werbefinanzierte Publisher, Affiliate-Seiten und reine Reichweitenprojekte verlieren ihre Grundlage, weil ihr Produkt der Seitenaufruf war.
Für ein Dienstleistungsunternehmen sieht die Rechnung anders aus. Dort war der Seitenaufruf nie das Produkt, sondern die Anfrage. Zwischen beidem liegt ein Entscheidungsprozess, und dieser Prozess wandert gerade in die Antwort hinein. Wenn ein Modell Ihre Marke nennt, Ihren Schwerpunkt korrekt beschreibt und Ihren Sitz richtig angibt, hat es einen Teil der Vorauswahl übernommen, ohne dass ein einziger Klick in Ihrem Analytics-Konto erscheint.
Weniger Traffic heißt deshalb nicht automatisch weniger Wirkung. Es heißt, dass die Wirkung an einer Stelle entsteht, die Ihre bisherigen Messwerkzeuge nicht sehen. Wer weiter nur Sitzungen zählt, misst einen schrumpfenden Ausschnitt und hält ihn für das Ganze.
Belastbare Zahlen dazu, wie viel wertvoller Besucher aus KI-Antworten sind, kursieren reichlich. Sie stammen fast alle aus Anbieterblogs mit unklarer Methodik und weit auseinanderliegenden Werten, deshalb steht hier keine. Was sich sauber sagen lässt: Der Besuch kommt später im Entscheidungsweg, weil die Vorauswahl schon stattgefunden hat.
GEO, AEO, LLMO, AIO, SGE, AI Mode: was die Begriffe wirklich unterscheiden
Um dieselbe Sache streiten derzeit ein halbes Dutzend Bezeichnungen. Ein Teil davon beschreibt Disziplinen, ein Teil beschreibt Produkte, und ein Teil ist schlicht veraltet.
| Begriff | steht für | meint konkret | wer benutzt ihn |
|---|---|---|---|
| GEO | Generative Engine Optimization | Sichtbarkeit in generierten Antworten über alle Systeme hinweg | Forschung, Agenturen, Toolanbieter |
| AEO | Answer Engine Optimization | Optimierung auf die eine Antwort statt auf die Liste, älter als die Sprachmodelle | klassische SEO-Szene |
| LLMO | Large Language Model Optimization | Blick aufs Modell selbst: Erwähnung, Trainingsdaten, Entitätsverständnis | technisch orientierte Teams |
| AIO | AI Optimization oder AI Overviews | doppeldeutig, mal Disziplin, mal Googles Antwortbox | uneinheitlich, oft missverständlich |
| SGE | Search Generative Experience | Googles Testname von 2023, aufgegangen in AI Overviews | historische Texte, Altbestand |
| AI Mode | Produktname von Google | Antwortmodus in der Google-Suche, keine Disziplin | Google und die Fachpresse |
Der Begriff GEO stammt aus einer Arbeit von Forschenden der Princeton University und des IIT Delhi, veröffentlicht 2023 unter dem Titel "GEO: Generative Engine Optimization" (https://arxiv.org/abs/2311.09735). Er benennt den Gegenstand präzise: die generative Maschine, nicht das einzelne Modell und nicht die einzelne Produktoberfläche.
Wir verwenden deshalb GEO. Dafür sprechen drei Gründe. Der Begriff hat eine wissenschaftliche Herkunft und keine Agentur-Erfindung hinter sich. Er umfasst alle sechs oben beschriebenen Systeme, während LLMO nur das Modell und AIO im engeren Sinn nur ein Google-Produkt meint. Und er ist der Begriff, nach dem der Markt tatsächlich sucht: Für "geo agentur" zeigt DataForSEO 1.000 Suchanfragen im Monat, über zwölf Monate flach, eigene Abfrage vom 02.09.2026.
AEO bleibt daneben brauchbar, wenn es um Featured Snippets in der Trefferliste und um Sprachassistenten geht. Es beschreibt aber eine ältere, engere Aufgabe.
Was sich für Ihre Marke ändert, wenn die Antwort die Trefferliste ersetzt
Der erste Unterschied ist die Erwähnung ohne Klick. Ihre Marke kommt in einem Satz vor, der Nutzer liest ihn, bewertet ihn, und geht weiter. Dieser Kontakt hat stattgefunden, aber er hinterlässt keine Zeile in Ihrem Server-Log. Sichtbarkeit und Messbarkeit fallen auseinander, und das gilt für Sie wie für Ihren Wettbewerb.
Der zweite Unterschied ist heikler. Ein Modell kann Sie falsch wiedergeben. Es kann einen veralteten Leistungsschwerpunkt nennen, den Sitz vertauschen, eine Kennzahl erfinden oder Sie mit einem ähnlich benannten Unternehmen verschmelzen. Es gibt keine Redaktion, bei der Sie das reklamieren. Korrigieren lässt sich das nur über die Quellenebene, also über die Texte, aus denen das System seine Aussagen zieht.
Das verschiebt die Verantwortung. Bisher haben Sie Ihre Außendarstellung kontrolliert, indem Sie Ihre Website kontrolliert haben. Jetzt kontrollieren Sie sie, indem Sie dafür sorgen, dass an mehreren unabhängigen Stellen dasselbe Richtige steht.
Der dritte Unterschied betrifft das Ziel der Arbeit. Ranking ist ein Platz, Zitiertwerden ist eine Rolle. Auf Platz drei zu stehen war eine Verhandlung um Aufmerksamkeit; im Antworttext genannt zu werden ist eine Entscheidung des Systems, Sie als Beleg zu verwenden. Diese Entscheidung fällt anhand von Kriterien, die mit Position wenig zu tun haben: eindeutige Benennung, überprüfbare Aussagen, Datum, Übereinstimmung mit anderen Quellen.
Damit ändert sich auch, woran Sie Fortschritt erkennen. Eine Rangliste ließ sich täglich abfragen und lieferte eine Zahl, die sich vergleichen ließ. Ein Zitat dagegen ist ein Ereignis: Es passiert bei einer bestimmten Frage, in einem bestimmten System, zu einem bestimmten Zeitpunkt, und es kann bei derselben Frage am nächsten Tag ausbleiben, ohne dass sich an Ihrer Seite etwas geändert hat. Wer das messen will, braucht wiederholte Abfragen über mehrere Systeme statt einer einzelnen Momentaufnahme.
Für die Praxis heißt das, den einen Satz zu bestimmen, der über Sie fallen soll. Er muss stimmen, er muss prüfbar sein, und er muss an mehr als einer Stelle im Netz belegt sein. Alles Weitere ist Handwerk.
Wie Sie messen, ob KI-Systeme Sie überhaupt nennen
Ohne Messung bleibt GEO Meinung. Bevor Sie irgendetwas an Ihrer Website ändern, brauchen Sie einen Nullwert: Wie oft taucht Ihre Marke heute in KI-Antworten auf, und wie oft wird Ihre Domain dabei als Quelle verlinkt? Beides lässt sich ohne Spezialwerkzeug erheben, wenn Sie ein festes Prompt-Set, einen festen Takt sowie eine Tabelle für die Antworten aufsetzen.
Die Cross-LLM-Messung läuft im Team, nicht im Tool: feste Prompts, mehrere Modelle, jede Antwort von Hand ausgewertet.
Ein brauchbares Prompt-Set deckt drei Absichten ab. Kommerzielle Prompts fragen nach einem Anbieter: "Welche Agentur für generative Suchmaschinenoptimierung ist in Deutschland empfehlenswert?" Informationelle Prompts fragen nach Wissen: "Wie funktioniert Generative Engine Optimization?" Vergleichsprompts stellen Optionen gegeneinander: "GEO oder klassische SEO — was bringt einem B2B-Anbieter mehr?" Für den Anfang reichen fünfzehn bis zwanzig Prompts, wenn sie die Sprache Ihrer Kunden treffen und nicht Ihre eigene Fachsprache spiegeln.
Die Formulierung muss danach eingefroren werden. Ein Prompt, den Sie zwischen zwei Messungen umschreiben, erzeugt keine Zeitreihe, sondern zwei unvergleichbare Momentaufnahmen. Legen Sie die Wortlaute in einer Datei ab. Jede Änderung daran bekommt ein Datum und eine Notiz.
Gemessen wird gegen mehrere Systeme parallel, weil jedes eine eigene Quellenauswahl hat. Sinnvoll ist mindestens je ein Lauf in ChatGPT, Perplexity, Google AI Overviews sowie Gemini oder Claude. Wichtig: neue Sitzung, kein Login-Verlauf, keine Personalisierung. Sonst messen Sie Ihre eigene Suchhistorie.
Wiederholt wird in festem Takt, monatlich oder zweiwöchentlich, immer am gleichen Wochentag. Aus den Läufen ergeben sich zwei Kennzahlen.
Nennungsrate: Zahl der Antworten, in denen Ihr Markenname im Fließtext vorkommt, geteilt durch die Zahl aller Läufe. Zwanzig Prompts über vier Systeme sind achtzig Läufe. Zwölf Nennungen darin ergeben eine Nennungsrate von 0,15.
Zitationsrate: Zahl der Antworten, in denen eine URL Ihrer Domain als Quelle ausgewiesen oder verlinkt ist, geteilt durch die Zahl aller Läufe. Sie liegt fast immer unter der Nennungsrate, und der Abstand zwischen beiden ist die eigentlich interessante Größe.
Nennung ohne Zitation heißt: Das Modell kennt Ihren Namen aus fremden Texten, hält Ihre eigene Seite aber nicht für belegfähig. Zitation ohne Nennung kommt vor, wenn Ihre Seite als Faktenquelle dient, Ihre Marke im Antworttext aber keine Rolle spielt.
Protokollieren Sie zusätzlich, wer stattdessen genannt wurde. Diese Liste ist später Ihre Zielliste.
Was Sie auf Ihrer Seite ändern, damit ein Modell Sie zitieren kann
Ein Sprachmodell zitiert eine Seite, wenn es dort eine klar abgegrenzte, überprüfbare Aussage findet, die zur Frage passt. Die folgenden Eingriffe erhöhen die Wahrscheinlichkeit dafür. Keiner davon ist ein Trick, und keiner ersetzt Substanz.
Die Antwort steht vor der Herleitung
Klassische Fachtexte bauen auf: Kontext, Problem, Argumentation, Ergebnis. Modelle extrahieren aber Passagen, keine Dramaturgie. Wenn die Antwort erst im letzten Absatz steht, wird der Abschnitt selten als geschlossene Einheit erkannt.
Drehen Sie das um. Jede Überschrift bekommt direkt darunter zwei bis vier Sätze, die die Frage vollständig beantworten, ohne den Rest des Textes zu brauchen. Danach folgt die Herleitung für menschliche Leser. Diese Antwortblöcke sollten den Markennamen enthalten, wo er sachlich hingehört, sonst zitiert das Modell Ihre Aussage ohne Sie.
Erkennbar umgesetzt ist das, wenn Sie einen beliebigen Abschnitt isoliert kopieren und er allein gelesen immer noch eine vollständige Antwort ergibt.
Entitäten statt Keywords
Suchmaschinen der alten Bauart matchten Zeichenketten. Modelle arbeiten mit Entitäten: benannten Dingen, die zueinander in Beziehung stehen. Ihre Seite wird nicht dadurch relevant, dass "GEO Agentur" achtmal vorkommt, sondern dadurch, dass Ihr Unternehmen erkennbar mit Themen, Orten, Personen, Verfahren sowie anderen Marken verknüpft ist.
Praktisch heißt das: Nennen Sie die Systeme beim Namen, gegen die Sie messen. Nennen Sie die Branchen, für die Sie arbeiten. Nennen Sie Normen und Verfahren, auf die Sie sich beziehen. Verlinken Sie die Seiten, die diese Begriffe bei Ihnen vertiefen, und halten Sie die Schreibweise Ihres Firmennamens über alle Seiten hinweg identisch.
Erkennbar umgesetzt ist das, wenn eine fremde Person nach dem Lesen einer einzigen Seite sagen kann, wer Sie sind, was Sie tun, für wen Sie arbeiten.
Strukturierte Daten, die zum sichtbaren Text passen
Schema.org-Auszeichnung ist kein Rankingfaktor, sondern eine Übersetzungshilfe. Sie sagt der Maschine, was auf der Seite ein Artikel ist, was eine Frage, was eine Organisation.
Für einen Wissenstext brauchen Sie drei Typen. Article mit headline, author, datePublished und dateModified. FAQPage für den Fragenblock, wobei jede Frage im Markup wortgleich mit der sichtbaren Überschrift sein muss. Organization einmal zentral, mit name, url, logo und sameAs-Verweisen auf Ihre Profile in Registern und Netzwerken.
Erkennbar umgesetzt ist das, wenn der Rich-Results-Test von Google alle drei Typen ohne Fehler ausliest und die dort angezeigten Werte mit dem übereinstimmen, was ein Mensch auf der Seite sieht.
Autor und Datum sichtbar, nicht nur im Quelltext
Ein Text ohne benannten Verfasser hat kein Herkunftssignal. Setzen Sie den vollen Namen, die Rolle sowie eine verlinkte Autorenseite sichtbar über oder unter den Text, dazu ein Veröffentlichungsdatum und, bei Aktualisierungen, ein Änderungsdatum mit einem Satz dazu, was sich geändert hat.
Die Autorenseite selbst sollte nachprüfbar sein: berufliche Stationen, Vorträge, Publikationen, Profile, die außerhalb Ihrer Domain existieren.
Erkennbar umgesetzt ist das, wenn beides ohne Scrollen im ersten Bildschirm steht und der Name zu einer Seite führt, die mehr enthält als ein Porträtfoto.
llms.txt als Wegweiser
Die Datei llms.txt liegt im Wurzelverzeichnis Ihrer Domain und listet in Markdown auf, welche Inhalte Sie haben und wo sie liegen. Sie ist ein Vorschlag der Community, kein verabschiedeter Standard, und kein System garantiert, dass es sie liest.
Der Aufwand ist trotzdem gering, und der Nutzen entsteht auch ohne Maschine: Wer die Datei sauber schreiben will, muss die eigene Informationsarchitektur einmal vollständig durchdenken. Tragen Sie dort Ihre Kernseiten mit einer Zeile Beschreibung ein und halten Sie sie aktuell.
Erkennbar umgesetzt ist das, wenn die Datei unter Ihrer Domain plus /llms.txt abrufbar ist und jede darin genannte URL tatsächlich existiert.
Saubere HTML-Struktur und Crawlbarkeit
Vieles scheitert vor dem Inhalt. Wenn der Text erst durch JavaScript entsteht, sehen ihn viele Crawler nicht. Wenn Ihre robots.txt die Bots der KI-Anbieter sperrt, werden Sie nicht zitiert, und das ist eine bewusste Entscheidung, die Sie kennen sollten.
Achten Sie auf eine einzige H1, eine lückenlose Hierarchie darunter, echte Absätze statt Zeilenumbrüchen, Tabellen als Tabellen, dazu Alternativtexte für jedes Bild. Serverseitig gerendertes HTML ist hier klar im Vorteil.
Erkennbar umgesetzt ist das, wenn Sie die Seite mit deaktiviertem JavaScript aufrufen und der gesamte Fließtext weiterhin lesbar ist.
Wie Sie in die Listen kommen, aus denen die Modelle zitieren
Der zweite Hebel liegt außerhalb Ihrer Domain. Fragt jemand nach Anbietern, greifen Modelle bevorzugt auf Seiten zu, die bereits mehrere Anbieter nebeneinander bewerten. Wer dort fehlt, existiert für die Antwort nicht, egal wie gut die eigene Seite ist.
Die Zielliste ergibt sich aus Ihrer eigenen Messung: Sortieren Sie die dort zitierten Quellen nach Häufigkeit und arbeiten Sie sie von oben ab.
Vergleichsartikel Dritter sind der direkteste Weg. Redaktionen und Fachblogs, die "Anbieter im Vergleich" pflegen, nehmen Ergänzungen oft auf, wenn Sie ihnen prüfbares Material liefern: Leistungsumfang, Referenzbranchen, Ansprechpartner, Belege. Manche Betreiber verkaufen Plätze; das ist zulässig, sollte aber als Werbung gekennzeichnet sein, und Sie sollten wissen, was Sie kaufen.
Fachportale und Branchenmedien wirken langsamer, aber stabiler. Ein Gastbeitrag mit eigener Position wird häufiger zitiert als eine Pressemitteilung, weil er zitierfähige Sätze enthält.
Branchenverzeichnisse und Kammerregister sind unspektakulär und trotzdem nützlich, weil sie strukturierte Daten liefern, die Modelle als Bestätigung Ihrer Existenz lesen. Wichtig ist überall dieselbe Schreibweise von Firmenname, Adresse sowie Domain.
Partnerverzeichnisse von Softwareherstellern sind oft die stärkste Einzelquelle. Wer als zertifizierter Partner eines Systems gelistet ist, taucht in Antworten auf, die nach Umsetzern für dieses System fragen. Der Eintrag ist meist an Schulungen oder Umsatzschwellen gebunden.
Digital PR bedeutet hier nicht Reichweite, sondern Zitierfähigkeit: eine Aussage, die andere übernehmen können, weil sie eine Zahl, ein Verfahren oder eine klare Gegenposition enthält.
Am besten trägt die eigene Erhebung. Wenn Sie messen, was in Ihrem Markt niemand gemessen hat, und die Methode offenlegen, entsteht Material, das andere zitieren müssen, wenn sie darüber schreiben.
Realistisch ist das Ganze kein Sprint. Eigene Seitenänderungen wirken auf die Nennungsrate erst, wenn die Modelle die Seite neu erfasst haben, und dieser Zyklus liegt außerhalb Ihrer Kontrolle. Externe Platzierungen brauchen Recherche, Ansprache, Redaktionsschluss, Freigabe. Rechnen Sie in Quartalen statt in Kalenderwochen, und messen Sie weiter, während Sie warten.
Woran Sie erkennen, dass GEO wirkt, und woran nicht
Vier Signale sagen etwas aus. Die Nennungsrate zeigt, ob Ihre Marke überhaupt im Antwortraum vorkommt. Die Zitationsrate zeigt, ob Ihre eigenen Seiten als Beleg taugen. Das Suchvolumen auf Ihren Markennamen zeigt, ob Menschen Sie nach einer KI-Antwort gezielt nachschlagen. Und die Qualität der eingehenden Anfragen zeigt, ob die Nennungen bei den richtigen Leuten landen.
Der vierte Punkt lässt sich schlecht automatisieren und ist trotzdem der härteste. Fragen Sie in jedem Erstgespräch, wie der Kontakt zustande kam. Antworten wie "ChatGPT hat euch genannt" tauchen inzwischen regelmäßig auf und sind ein direkteres Signal als jede Kennzahl.
Wenig aussagekräftig sind dagegen: einzelne Screenshots einer guten Antwort, Sichtbarkeitsindizes ohne offengelegte Prompt-Basis, Impressionen aus der Search Console als Beleg für KI-Sichtbarkeit sowie jede Kennzahl, die aus einem einzigen Lauf in einem einzigen Modell stammt. Modelle antworten nicht deterministisch. Ein Treffer ist Zufall, eine Quote ist Information.
Misstrauisch sollten Sie bei Zusicherungen werden, Ihre Marke lasse sich auf einen bestimmten Platz in KI-Antworten bringen. Es gibt keine Positionen, die jemand vergeben könnte, keine Indexierung, die sich beantragen ließe, und keinen Anbieter mit Zugriff auf die Gewichte der Modelle. Wer Platzierungen zusagt, verkauft etwas, das er nicht liefern kann. Seriös ist die Zusage einer Methode, einer Messung sowie eines nachvollziehbaren Berichts.
Wenn Sie das nicht selbst aufbauen wollen: Was eine GEO-Leistung konkret umfasst.
Häufige Fragen
Was ist Generative Engine Optimization?
Generative Engine Optimization bezeichnet die Arbeit daran, dass Sprachmodelle sowie KI-Suchsysteme Ihre Marke in ihren Antworten nennen und Ihre Inhalte als Quelle verwenden. Optimiert wird nicht auf eine Position in einer Ergebnisliste, sondern auf Vorkommen in einem generierten Text. Dazu gehören zwei Richtungen: Ihre eigenen Seiten so aufbauen, dass sich Aussagen sauber entnehmen lassen, und dafür sorgen, dass Dritte Sie in Quellen erwähnen, aus denen die Systeme bevorzugt schöpfen. Gemessen wird über wiederholte Prompt-Läufe, nicht über Rankings.
Was unterscheidet GEO von SEO?
Der Unterschied liegt im Ziel der Optimierung. SEO arbeitet auf eine Platzierung in einer Liste von Links hin, auf die jemand klickt. GEO arbeitet darauf hin, Teil einer fertigen Antwort zu sein, die oft ohne Klick gelesen wird. Daraus folgen andere Kennzahlen: Nennungsrate und Zitationsrate statt Position und Klickrate. Die technische Basis überschneidet sich stark, denn beides braucht crawlbare Seiten und belastbare Inhalte. Die Textform unterscheidet sich, weil Modelle Passagen entnehmen und keine Spannungsbögen lesen.
Kann meine bestehende SEO-Arbeit in GEO überführt werden?
Ja, der größere Teil davon. Technische Erreichbarkeit, saubere Seitenstruktur, interne Verlinkung, strukturierte Daten, thematische Tiefe zahlen unverändert ein. Umgebaut werden muss vor allem die Textarchitektur: Antworten nach vorn, klar abgegrenzte Abschnitte, benannte Entitäten statt Keyword-Dichte, sichtbare Autoren, sichtbare Daten. Dazu kommt ein Bereich, den klassische SEO kaum abdeckt, nämlich die gezielte Präsenz in Vergleichsartikeln und Verzeichnissen Dritter. Wer eine gepflegte SEO-Basis hat, startet nicht bei null, sondern bei der Umformung.
Wie lange dauert es, bis GEO wirkt?
Das hängt an zwei Zyklen, die Sie nur teilweise steuern. Änderungen an Ihren Seiten wirken erst, wenn die Systeme sie neu erfasst haben; bei Suchmaschinen-gestützten Antworten geht das schneller als bei rein trainingsbasiertem Wissen. Externe Platzierungen brauchen Recherche, Ansprache, Redaktionszyklen. Sinnvoll ist deshalb, in Quartalen zu denken und die Nennungsrate währenddessen im festen Takt weiterzumessen. Ohne Nullmessung zu Beginn können Sie später keine Veränderung nachweisen, sondern nur behaupten.
Wie messe ich, ob eine KI meine Marke empfiehlt?
Über ein festes Prompt-Set, das Sie wiederholt gegen mehrere Systeme laufen lassen. Formulieren Sie fünfzehn bis zwanzig Fragen aus Kundensicht, gemischt aus kommerziellen, informationellen sowie vergleichenden Anliegen. Frieren Sie den Wortlaut ein. Führen Sie jeden Prompt in einer neuen Sitzung ohne Login aus, damit Personalisierung das Ergebnis nicht verfälscht. Protokollieren Sie pro Lauf, ob Ihr Name genannt und ob Ihre Domain verlinkt wurde, und wer sonst erschien. Daraus ergeben sich Nennungsrate, Zitationsrate sowie eine Zielliste fremder Quellen.
Was kann ich tun, wenn eine KI Falsches über meine Marke sagt?
Zuerst die Herkunft klären: Lassen Sie sich die Quellen der Antwort anzeigen und prüfen Sie, welche Seite den Fehler enthält. Meist stammt er aus einem veralteten Verzeichniseintrag, einem alten Pressetext oder einer fremden Vergleichsseite. Korrigieren Sie die Quelle dort, wo sie steht, und veröffentlichen Sie auf Ihrer eigenen Domain eine eindeutige, datierte Richtigstellung. Zusätzlich bieten mehrere Anbieter Meldewege für fehlerhafte Ausgaben an. Eine sofortige Korrektur im Modell gibt es nicht; die Wirkung entsteht über die Quellenlage.
Funktioniert GEO für B2B genauso wie für B2C?
Die Mechanik ist gleich, die Gewichtung nicht. Im B2B sind die Fragen länger, spezifischer, stärker auf Vergleiche ausgerichtet, weshalb Fachportale, Partnerverzeichnisse von Softwareherstellern sowie eigene Erhebungen besonders stark tragen. Im B2C entscheiden Bewertungsplattformen, Marktplätze sowie redaktionelle Bestenlisten mehr. Auch der Nutzen unterscheidet sich: Ein B2B-Anbieter braucht wenige, gut passende Anfragen, ein Konsumentenanbieter braucht Reichweite. Das Prompt-Set spiegelt diesen Unterschied und sollte im B2B enger auf Anwendungsfälle geschnitten sein. Für standortgebundene Anbieter kommt eine dritte Ebene dazu, beschrieben unter Local GEO.
Brauche ich eine llms.txt?
Zwingend ist sie nicht. llms.txt ist ein Community-Vorschlag und kein verabschiedeter Standard, und kein Anbieter sagt zu, die Datei auszuwerten. Sie schadet aber nicht, kostet wenig Aufwand, zwingt Sie, Ihre wichtigsten Inhalte einmal zu ordnen und zu beschreiben. Wenn Sie sie anlegen, halten Sie sie knapp, verweisen Sie nur auf Seiten, die es wirklich gibt, und pflegen Sie sie mit, sobald sich die Struktur ändert. Wichtiger bleiben crawlbares HTML, klare Antwortblöcke und Erwähnungen auf fremden Seiten.