Wer wissen will, ob seine Arbeit an der Sichtbarkeit in KI-Antworten etwas bewirkt, braucht zuerst eine Zahl von vorher. Sonst gibt es später nur Eindrücke: Ein Kunde erwähnt beiläufig, er habe die Firma „irgendwo bei ChatGPT gesehen". Ein Mitarbeiter tippt einen Prompt ein und findet den eigenen Namen. Beides fühlt sich nach Erfolg an, und beides trägt keine Entscheidung. Ohne Ausgangswert ist jede spätere Aussage über Fortschritt unbelegbar, weil es nichts gibt, wogegen sich das Ergebnis halten ließe.
Das ist der praktische Grund, warum am Anfang eine Messung steht und nicht eine Maßnahme. Der zweite Grund ist unangenehmer: Ohne Nullpunkt lässt sich jede beliebige spätere Zahl als Verbesserung verkaufen. Eine Nennungsrate von einem Fünftel klingt gut, solange niemand fragt, ob sie vorher bei einem Zwanzigstel oder bei einem Drittel lag.
Dieser Text legt die Methode vollständig offen. Kein Verfahrenshinweis, sondern die Rechenwege und die Definitionen sowie die Fehler, die in der Praxis am häufigsten passieren. Der Grund dafür ist nüchtern: Von den zehn Agenturen in unserer eigenen Vergleichsliste hat genau eine eine echte eigene Erhebung zur KI-Sichtbarkeit veröffentlicht. Über eine offengelegte Methode redet fast niemand, was daran liegen dürfte, dass eine offengelegte Methode nachprüfbar ist.
Wir verschenken damit Handwerk, und zwar absichtlich. Wer die Messung einmal selbst durchführt, versteht danach, warum die Auswertung Zeit kostet. Er entscheidet auf besserer Grundlage, ob er sie im Haus behält oder abgibt. Was GEO überhaupt ist und wovon hier die Rede ist, steht in unserer Erklärung zu GEO.
Was Sie messen — die vier Kennzahlen
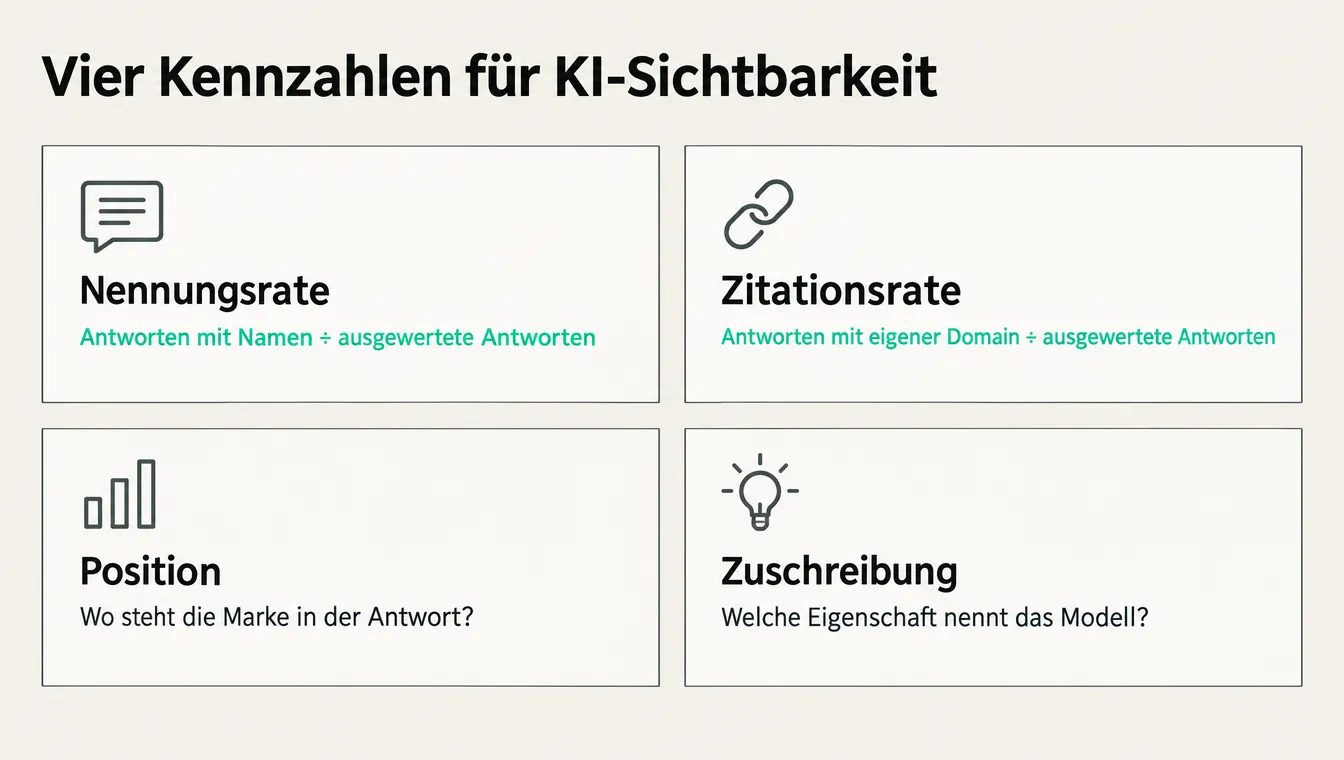
Vier Kennzahlen reichen für einen belastbaren Ausgangswert. Zwei davon sind Raten und lassen sich rechnen. Zwei sind Beobachtungen und müssen von Hand protokolliert werden. Alle vier beziehen sich immer auf eine feste Menge ausgewerteter Antworten, nie auf ein Gefühl und nie auf eine einzelne Abfrage.
Nennungsrate. Die Nennungsrate sagt, in wie vielen ausgewerteten Antworten die Marke namentlich vorkommt. Namentlich heißt: Der Firmenname steht im gerenderten Antworttext. Eine Umschreibung wie „eine Kölner Agentur" zählt nicht, auch wenn offensichtlich ist, wer gemeint sein könnte. Die Bezugsgröße im Nenner ist nicht die Zahl der angesetzten Prompts, sondern die Zahl der Antworten, die tatsächlich vollständig ausgewertet wurden.
Nennungsrate = Antworten mit namentlicher Nennung / ausgewertete Antworten
Das Ergebnis ist eine Rate, keine Position. Sie sagt aus, wie oft die Marke überhaupt in den Text gelangt, und sie sagt nichts darüber, wie knapp das jeweils war. Wer diese Zahl ohne das zugehörige Prompt-Set nennt, nennt eine Zahl ohne Bezugsgröße. Fünf freundlich formulierte Prompts erzeugen eine andere Nennungsrate als fünf kommerzielle, und beide Werte sind für sich genommen korrekt.
Zitationsrate. Die Zitationsrate zählt etwas anderes: in wie vielen Antworten die eigene Domain als Quelle verlinkt oder als Beleg angeführt wird. Gemessen wird die Domain, nicht der Name. Ein Link auf ein Branchenverzeichnis, in dem die Firma steht, ist keine Zitation der eigenen Domain.
Zitationsrate = Antworten mit Quellenverweis auf die eigene Domain / ausgewertete Antworten
Nennung und Zitat werden getrennt gezählt, weil sie unabhängig voneinander auftreten. Eine Antwort kann die Marke nennen und dabei ein Verzeichnis, einen Presseartikel oder ein Bewertungsportal als Beleg verlinken. Dann ist die Marke sichtbar, aber die eigene Seite trägt nichts dazu bei. Umgekehrt kann eine Antwort die eigene Domain als Quelle führen, ohne den Firmennamen im Fließtext zu erwähnen. Dann liefert die Seite Substanz, bekommt aber keine Sichtbarkeit. Wer beides in eine Zahl wirft, kann diese zwei Zustände nicht mehr auseinanderhalten und arbeitet anschließend am falschen Hebel. Der eine Fall verlangt Arbeit an fremden Quellen, der andere Arbeit an der eigenen Positionierung im Text.
Position innerhalb der Antwort. Die dritte Kennzahl ist keine Rate, sondern eine Notiz: An welcher Stelle steht die Marke im Antworttext? Als erster genannter Anbieter, in der Mitte einer Aufzählung, oder in einem Nachsatz nach dem eigentlichen Vorschlag? Protokolliert wird die Stelle in der gerenderten Antwort, ergänzt um die unmittelbare Umgebung, also den Satz davor und danach.
Eine generierte Antwort ist Fließtext, kein sortiertes Verzeichnis. Trotzdem liest niemand sie neutral. Was zuerst kommt, wird gelesen. Was nach dem dritten Namen kommt, oft nicht mehr. Diese Beobachtung lässt sich nicht in eine saubere Prozentzahl übersetzen, und wir tun auch nicht so. Sie wird als Rangnotiz je Antwort geführt und über mehrere Läufe hinweg betrachtet. Wandert die Marke über Wochen von hinten nach vorne, ist das ein Signal. Ein einzelner Spitzenplatz in einer einzelnen Antwort ist keins.
Zuschreibung. Die vierte Kennzahl ist die qualitative: Welche Eigenschaft schreibt das Modell der Marke zu? Wird sie als Spezialist für ein Thema geführt, als regionaler Anbieter, als günstige Option, als Ansprechpartner für große Budgets? Festgehalten wird die Formulierung im Wortlaut, nicht ihre Zusammenfassung.
Diese Zuschreibung entscheidet, ob eine Nennung überhaupt nützlich ist. Wer bei einem Prompt nach günstigen Anbietern genannt wird, aber Projekte im oberen Preissegment verkauft, hat eine Nennung und trotzdem ein Problem. Die Zuschreibung ist außerdem die einzige der vier Kennzahlen, die direkt zeigt, was die Modelle aus den vorhandenen Quellen über die Marke gelernt haben. Wiederholt sich eine falsche Zuschreibung über mehrere Modelle hinweg, liegt der Fehler mit hoher Wahrscheinlichkeit im eigenen Bestand und nicht im System.
Warum eine einzelne Messung nichts wert ist
Am 05.09.2026 haben wir den Google AI Mode auf google.de abgefragt, ohne Login, ohne Personalisierung, jede Abfrage in einer frischen Sitzung. Fünf kommerzielle Prompts waren angesetzt, vier davon konnten ausgewertet werden. Über diese vier Antworten wurden 25 verschiedene Agenturen genannt, und es gab genau eine Überschneidung (eigene Messung, 05.09.2026). Ein einziges Unternehmen kam in zwei der vier Antworten vor. Sonst keines zweimal.
Vier eng verwandte Fragen, an einem Tag, in einem System, und die Antwortmengen sind praktisch disjunkt. Wer aus einer dieser vier Antworten eine Aussage über den Markt ableitet, leitet eine Aussage aus Rauschen ab. Wer eine davon als Bestenliste weiterreicht, zeigt in Wahrheit das Ergebnis einer einzigen Formulierung.
Daraus folgt die Regel für jede Erhebung, die etwas taugen soll. Mehrere Prompts, damit die Formulierung nicht das Ergebnis bestimmt. Mehrere Läufe, damit ein Zufallstreffer nicht als Zustand durchgeht. Und ein fester Takt, damit die Werte über die Zeit vergleichbar bleiben. Ein Takt bedeutet: gleiches Prompt-Set, gleiche Abfragebedingungen, gleicher Wochentag. Ändert sich mitten in der Reihe das Prompt-Set, beginnt eine neue Reihe, und die alte Zahl ist kein Vergleichswert mehr.
Einen Punkt aus derselben Messung führen wir gesondert, weil er über die Sauberkeit der ganzen Rechnung entscheidet. Der fünfte Prompt brach beim Rendern der Antwort ab. Er wird als nicht ausgewertet geführt, nicht als Null.
Der Unterschied ist der zwischen „nicht genannt" und „nicht gemessen". Eine Null bedeutet: Die Antwort lag vollständig vor, sie wurde gelesen, und die Marke kam nicht darin vor. Das ist ein Befund. Ein Abbruch bedeutet: Es gibt keine Antwort, über die sich etwas sagen ließe. Das ist kein Befund, sondern eine Lücke im Datensatz.
Wer den Abbruch als Null verbucht, verfälscht beide Kennzahlen in dieselbe Richtung. Der Nenner wächst um eine Antwort, die nie ausgewertet wurde, der Zähler bleibt gleich, und die Nennungsrate fällt. Bei fünf Prompts verschiebt ein einziger falsch gebuchter Abbruch das Ergebnis von einem Viertel auf ein Fünftel, ohne dass sich an der Sichtbarkeit irgendetwas geändert hätte. Umgekehrt kann derselbe Fehler eine spätere Verbesserung vortäuschen, wenn beim nächsten Lauf zufällig alle Abfragen durchlaufen. Deshalb wird jeder Abbruch mit Zeitstempel und Grund protokolliert und aus der Rechnung genommen.
Der Nullpunkt
Eine Null ist ein vollwertiger Messwert. Sie ist unangenehm zu veröffentlichen und trotzdem die belastbarste Zahl, die eine Erhebung am Anfang hervorbringen kann, weil sie sich nicht schönrechnen lässt.
So sieht ein Nullpunkt aus: Bei einer Cross-LLM-Messung über mehrere kommerzielle Prompts kann eine Marke in null von allen ausgewerteten Antwortmengen erscheinen — Nennungsrate 0 Prozent, Zitationsrate 0 Prozent. Position innerhalb der Antwort und Zuschreibung entfallen dann, weil es nichts zu protokollieren gibt.
So wird ein Nullpunkt festgehalten: mit Datum, mit dem verwendeten Prompt-Set, mit den Abfragebedingungen und mit der Zahl der ausgewerteten Antworten im Nenner. Ohne diese vier Angaben ist auch eine Null wertlos, weil niemand sie später reproduzieren kann. Mit ihnen ist sie der Bezugspunkt, gegen den jede weitere Messung gerechnet wird.
Der praktische Nutzen dieser Zahl zeigt sich erst später. Steigt die Nennungsrate im Frühjahr auf zwei von fünf Antworten, ist die Aussage belegbar, weil der Startwert dokumentiert ist. Fehlt der Startwert, bleibt von derselben Entwicklung nur eine Behauptung übrig. Wer wissen will, was eine solche Messreihe im Betrieb kostet, findet die Einordnung unter GEO-Kosten.
Was Google selbst anbietet — und warum es nicht reicht
Google äußert sich zu diesem Thema selbst. Im Leitfaden zur Optimierung für generative KI-Funktionen empfiehlt Google unter anderem, mit der Search Console zu messen, und nennt dafür den Bericht zur Leistung generativer KI-Funktionen (Quelle: Google Search Central, zuletzt aktualisiert 10.07.2026). Zu Dateien heißt es dort wörtlich: „Sie müssen neue maschinenlesbare Dateien, KI-Textdateien oder spezielles Markup nicht erstellen. Google Search verwendet diese nicht."
Diese Quelle ist die beste, die es für Google gibt. Sie kommt vom Betreiber, sie beruht auf dessen eigenen Daten, und sie ist keine Schätzung von außen. Wer die Search Console ohnehin nutzt, sollte diesen Bericht ansehen, bevor er irgendetwas anderes aufsetzt.
Die Grenze liegt im Namen. Der Bericht deckt Google ab. Er sagt nichts darüber, ob ChatGPT die Marke nennt, ob Perplexity die eigene Domain als Quelle führt oder wie Gemini die Marke beschreibt. Eine Erhebung über mehrere Anbieter hinweg misst Ergebnisse in Systemen, zu denen es keinen Bericht vom Betreiber gibt. Google liefert präzise Daten für einen Ausschnitt. Die eigene Erhebung liefert gröbere Daten für die Breite.
Beides gehört nebeneinander, und keins ersetzt das andere. Wer nur die Search Console liest, hält den Google-Ausschnitt für die ganze Lage. Wer nur eigene Prompts abfragt, verzichtet auf die einzige Datenquelle, die nicht aus abgelesenen Antworten besteht. Wie sich die klassische Auffindbarkeit dazu verhält, steht in GEO vs. SEO.
Das Prompt-Set aufbauen
Die Kennzahlen sind nur so gut wie die Fragen, aus denen sie entstehen. Eine Nennungsrate von zwei Fünfteln bedeutet nichts, solange niemand weiß, auf welche Fragen sich diese Rate bezieht. Deshalb steht am Anfang jeder Messung eine feste Liste von Fragen, und diese Liste ist ein eigenes Arbeitsergebnis.
Der erste Denkfehler liegt beim Zuschnitt. Wer aus der Suchmaschinenarbeit kommt, schreibt Keywords hin: „GEO Agentur", „Sichtbarkeit KI", „Beratung Köln". Damit lässt sich ein Sprachmodell nicht sinnvoll befragen, weil niemand so mit ihm redet. Menschen tippen in ein Chatfenster ganze Kaufsituationen: Sie beschreiben ihre Lage, nennen ihre Bedingungen und fragen nach einer Empfehlung. Ihre Fragen müssen genauso aussehen. Nehmen Sie die Sätze, die Ihre Interessenten im Erstgespräch tatsächlich sagen, und schreiben Sie sie als Frage auf.
Der zweite Punkt ist der Wortlaut. Sobald eine Frage im Set steht, wird sie eingefroren. Kein Wort ändert sich mehr, keine Umstellung, kein zusätzlicher Ortsname. Der Grund ist nicht Pedanterie: Eine geänderte Frage misst eine andere Größe. Wenn Sie im Januar „Wer hilft mir, in KI-Antworten sichtbar zu werden?" fragen und im April „Welche Agentur macht GEO?", dann vergleichen Sie zwei verschiedene Erhebungen und nennen das Ergebnis Entwicklung. Der eingefrorene Wortlaut ist das, was die Zeitreihe überhaupt erst zu einer Zeitreihe macht.
Unser eigener Aufbau sieht so aus: Prompt-Set v1 mit 56 Prompts in 13 Clustern, gepflegt als Steuerdatei, Stand: September 2026. Steuerdatei heißt, dass die Liste nicht in einem Dokument liegt, sondern in einer Datei, aus der die Abfrage direkt läuft. Jede Zeile trägt ihren Cluster mit Nummer und ihren unveränderten Text. Wer den Wortlaut ändern will, ändert nicht die Zeile, sondern legt eine neue an.
Die 13 Cluster sind unser Geschäft, Ihre werden anders heißen. Übertragbar sind dagegen die Frageklassen. Fünf davon gehören in jedes Set:
Allgemeine Anbieterfrage. „Welche Anbieter gibt es für [Ihre Leistung]?" Die breiteste Form, meist mit der längsten Anbieterliste in der Antwort und dem härtesten Wettbewerb.
B2B-Variante mit Rolle und Größe. „Ich bin Geschäftsführer eines Maschinenbauers mit 80 Mitarbeitern und suche [Leistung]. Wen soll ich ansprechen?" Hier trennt sich, ob ein Modell Sie einer Zielgruppe zuordnet.
Ortsbezug. „Wer bietet [Leistung] in [Stadt] an?" Ortsbezogene Antworten fallen erfahrungsgemäß anders aus als bundesweite und verdienen eine eigene Zeile.
Vergleichsfrage. „Was ist der Unterschied zwischen [Leistung A] und [Leistung B], und wer macht beides?" Diese Klasse liefert die Zuschreibungen: Sie zeigt, welche Eigenschaft ein Modell Ihnen zutraut.
Problemfrage ohne Anbieterbezug. „Meine Website wird von KI-Assistenten nicht empfohlen. Was kann ich tun?" Hier taucht ein Anbieter nur auf, wenn seine Inhalte die Frage tatsächlich beantworten.
Rechnen Sie pro Klasse mit mehreren Varianten, sonst hängt Ihr Ergebnis an einer Formulierung. Und schreiben Sie jede Frage so, dass sie ohne Sie funktioniert: Ein Prompt mit Ihrem Markennamen prüft die Rechtschreibung des Modells, nicht Ihre Sichtbarkeit.
Die Durchführung
Google AI Mode abfragen. Der AI Mode wird über den Parameter udm=50 auf google.de aufgerufen. Dazu kommen hl=de, gl=de und pws=0, damit Sprache und Land feststehen und die Personalisierung abgeschaltet ist. Abgefragt wird ohne Login, jede Frage in einer frischen Sitzung. Wer eingeloggt misst, misst seinen eigenen Verlauf mit.
Der wichtigste Punkt ist unspektakulär und wird trotzdem am häufigsten übergangen: Die Antwort braucht nach unserer eigenen Messung rund 35 Sekunden, bis sie fertig gerendert ist. Wer früher ausliest, protokolliert eine halbe Antwort — und eine halbe Antwort sieht im Protokoll genauso vollständig aus wie eine ganze. Ausgewertet wird der gerenderte Text, also das, was ein Mensch auf dem Bildschirm liest, nicht der Quelltext der Seite.
Mehrere Modelle abfragen. Ein System allein ergibt kein Bild. Unser eigener Messapparat umfasst sieben Modelle über vier Anbieter, Stand: September 2026. Jede Frage läuft durch jedes System, und jede Antwort wird protokolliert, auch die, in der nichts Brauchbares steht. Gerade die leeren Antworten tragen den Nullpunkt.
Wichtig ist die Trennung: Ziehen Sie die Systeme nicht zu einer Zahl zusammen, bevor Sie sie einzeln notiert haben. Eine Marke kann in einem System regelmäßig vorkommen und in einem anderen gar nicht. Ein Mischwert versteckt genau die Information, wegen der Sie messen. Was hinter dem Begriff steckt, haben wir unter was GEO ist ausführlicher beschrieben.
Protokollieren. Die Rohdatei ist der eigentliche Wert der Erhebung, nicht die Auswertung. Sie muss so vollständig sein, dass ein Dritter Ihre Zahl nachrechnen kann, ohne Sie zu fragen. In jede Zeile gehören:
Datum und Uhrzeit der Abfrage
die Frage im Wortlaut, kopiert aus der Steuerdatei
das abgefragte System
die vollständige Antwort, ungekürzt
alle darin genannten Namen, Anbieter wie Marken
alle verlinkten oder als Beleg angeführten Quellen
Ungekürzt heißt ungekürzt. Sobald jemand beim Protokollieren zusammenfasst, ist die Position innerhalb der Antwort verloren, und die Zuschreibung meistens auch.
Auswerten. Für diesen Schritt gibt es kein Werkzeug, das Ihnen die Arbeit abnimmt. Ob eine Nennung eine Empfehlung ist oder eine Aufzählung am Rand, an welcher Stelle sie steht, welche Eigenschaft das Modell Ihnen zuschreibt: Das liest ein Mensch. Eine Marke kann in einer Antwort dreimal vorkommen und trotzdem nur als Gegenbeispiel dienen. Ein Zählskript sieht drei Treffer.
Der Ablauf ist immer derselbe. Antwort vollständig lesen. Nennungen markieren, Ihre und die der anderen. Die angeführten Quellen mit der Liste der genannten Namen abgleichen, weil Nennung und Beleg auseinanderfallen. Erst dann die Zeile in die Tabelle eintragen: Nennung ja oder nein, Zitation ja oder nein, Position, Zuschreibung im Klartext.
Zum Zeitaufwand eine ehrliche Größenordnung: Die Abfrage selbst ist ein Bruchteil der Arbeit, die Auswertung der weitaus größere Teil. Rechnen Sie für die Bewertung eines vollständigen Sets über mehrere Systeme mit einem Arbeitstag in der gleichen Größenordnung, in der Sie sonst eine Inhaltsanalyse ansetzen, und mit weniger, sobald das Schema sitzt und die Tabelle steht. Diese Zeit ist der Grund, warum laufende Messung Geld kostet, egal ob intern oder extern; was die Treiber dahinter sind, steht in unserer Preisseite.
Die Gewichtung offenlegen
Aus den Kennzahlen entsteht am Ende ein Score, damit sich Erhebungen untereinander vergleichen lassen. Unsere Formel gewichtet 40/30/30, das ist unsere eigene Festlegung, Stand: September 2026.
Und genau so gehört sie gelesen: als unsere Gewichtung, nicht als die richtige. Es gibt für diese Disziplin keinen eingeführten Standard, an dem sich eine Gewichtung messen ließe. Wer die Zitation höher zieht als wir, weil ihm der Beleg wichtiger ist als der Name, bekommt aus denselben Rohdaten einen anderen Punktwert. Das ist kein Fehler, sondern eine andere Entscheidung.
Daraus folgt eine einfache Regel: Die Gewichtung wird veröffentlicht, nicht versteckt. Ein Score ohne offengelegte Formel ist eine Zahl, die niemand prüfen kann, und aus der sich nicht einmal ablesen lässt, ob eine Verbesserung aus mehr Nennungen kommt oder aus einer Änderung an der Rechnung. Schreiben Sie Ihre Gewichtung neben das Ergebnis. Wenn Sie sie später ändern, endet die alte Reihe.
Fehlerquellen
Sechs Fehler kosten in der Praxis die meiste Aussagekraft:
Zu früh ausgelesen. Der häufigste technische Fehler. Die Antwort ist noch nicht fertig gerendert, im Protokoll landet ein Fragment, und die fehlenden Nennungen zählen als Abwesenheit.
Eingeloggt gemessen. Mit aktivem Konto und Verlauf messen Sie Ihre eigene Nutzungsgeschichte. Der Wert ist real, aber er gilt nur für Sie.
Frage zwischen zwei Läufen geändert. Auch eine Kleinigkeit reicht. Der Vergleich mit der Vormessung ist damit hinfällig, selbst wenn beide Zeilen gleich aussehen.
Abgebrochenen Lauf als Null gezählt. Ein Lauf, der beim Rendern abbricht, ist keine Antwort ohne Nennung, sondern keine Antwort. In unserer Messung am 05.09.2026 waren fünf Prompts angesetzt und vier auswertbar; der fünfte lief als nicht ausgewertet, nicht als Null.
Nur ein System abgefragt. Ein einzelnes System beschreibt einen Ausschnitt. Wer daraus eine Aussage über KI-Sichtbarkeit macht, verallgemeinert eine Stichprobe von eins.
Nur einmal gemessen. Eine einzelne Messung ist Rauschen. Über vier ausgewertete Antworten derselben Erhebung am 05.09.2026 kamen 25 verschiedene Agenturen vor, mit genau einer Überschneidung. Erst mehrere Prompts und mehrere Läufe ergeben eine Aussage.
Takt und Fortschreibung
Messung wird zur Zeitreihe, wenn der Rhythmus fest ist. Legen Sie einen Takt fest, der zu Ihrem Aufwand passt, und halten Sie ihn. Monatlich ist für die meisten Unternehmen ausreichend, vierzehntägig sinnvoll, wenn viel Inhalt neu entsteht. Entscheidend ist nicht die Frequenz, sondern dass sie sich nicht ändert: Ein unregelmäßiger Takt erzeugt Bewegung, die aus dem Kalender kommt und nicht aus dem Markt.
Gleich bleiben müssen drei Dinge: die Fragen im Wortlaut, dazu die abgefragten Systeme und die Art, wie ausgewertet wird. Wer mitten in der Reihe eine zusätzliche Frage aufnimmt, ein System ergänzt oder die Bewertungsregel verschiebt, verändert die Grundgesamtheit.
Trotzdem wird jedes Prompt-Set irgendwann fortgeschrieben, weil Leistungen dazukommen und Formulierungen veralten. Der saubere Umgang damit: Die alte Reihe endet mit einer letzten vollständigen Messung, das neue Set bekommt eine neue Versionsnummer, und die neue Reihe beginnt bei null. Beide Reihen bleiben erhalten, keine wird rückwirkend umgerechnet. In der Auswertung steht dann ein Schnitt, und an diesem Schnitt steht, was geändert wurde und warum.
Häufige Fragen
Wie viele Prompts brauche ich mindestens?
Weniger als zehn ergeben keine belastbare Rate, weil jede einzelne Antwort den Wert um zehn Prozentpunkte verschiebt. Ein praktikabler Einstieg liegt bei zwanzig bis dreißig Fragen, verteilt über die fünf Frageklassen und über Ihre wichtigsten Leistungen. Wichtiger als die Zahl ist die Verteilung: Zwanzig Fragen zu einem Thema messen ein Thema, nicht Ihr Geschäft. Unser eigenes Set ist über die Jahre auf 56 Prompts gewachsen, Stand: September 2026 — angefangen haben wir kleiner.
Kann ich das automatisieren?
Die Abfrage teilweise, die Bewertung nicht. Das Aufrufen der Frage, das Warten bis zum fertigen Rendern und das Ablegen der Antwort lassen sich technisch abbilden. Die Entscheidung, ob eine Nennung eine Empfehlung ist, welche Position sie hat und welche Eigenschaft zugeschrieben wird, trifft ein Mensch am Text. Wer die Auswertung automatisiert, tauscht Genauigkeit gegen Geschwindigkeit und bekommt Zahlen, die stabil aussehen und nicht stimmen.
Wie oft sollte ich messen?
Monatlich reicht in den meisten Fällen aus, um Bewegung zu erkennen, ohne den Aufwand zu übertreiben. Häufiger lohnt, wenn Sie gerade viel veröffentlichen oder eine gezielte Maßnahme prüfen wollen. Seltener als quartalsweise wird schwierig, weil zwischen zwei Punkten zu viel passiert und sich Ursachen nicht mehr zuordnen lassen. Entscheiden Sie sich einmal und bleiben Sie dabei; ein verschobener Termin kostet Sie mehr Aussagekraft als eine niedrigere Frequenz.
Was, wenn ich gar nicht vorkomme?
Dann haben Sie einen Messwert, keinen Fehler. Das kommt in der Praxis regelmäßig vor: Eine Marke kann bei einer Cross-LLM-Messung über mehrere kommerzielle Prompts in null von allen Antwortmengen erscheinen, Nennungsrate 0 Prozent, Zitationsrate 0 Prozent. Ein Nullpunkt ist der Bezugswert, gegen den jede spätere Messung läuft. Ohne ihn können Sie sechs Monate später nur behaupten, dass es besser geworden ist.
Reicht die Search Console?
Sie hilft, deckt aber nur Google ab. Google Search Central empfiehlt in seinem Leitfaden zur Optimierung für generative KI-Funktionen, zuletzt aktualisiert am 10.07.2026, ausdrücklich die Messung über die Search Console und nennt dafür den Bericht zur Leistung generativer KI-Funktionen. Das ist eine offizielle Quelle und gehört genutzt. Sie sagt Ihnen jedoch nichts darüber, was andere Systeme antworten, und nichts darüber, wie Sie in einer Antwort beschrieben werden. Beides misst nur die eigene Erhebung.
Kann ich das selbst machen?
Ja. Alles, was hier steht, lässt sich ohne uns durchführen: Fragen schreiben, einfrieren, abfragen, protokollieren, von Hand auswerten, Gewichtung offenlegen, Takt halten. Genau deshalb existiert diese Anleitung. Wer die Messung einmal selbst gefahren hat, weiß danach, wo die Zeit hingeht, und entscheidet auf besserer Grundlage, ob er sie im Haus behält oder abgibt. Wenn Sie sie abgeben wollen, sprechen Sie uns an — und wenn nicht, haben Sie hier alles, was Sie dafür brauchen.